트랜스포머 뜯어보기: 인코더
앞 장에서는 셀프 어텐션을 통해 각 토큰이 문장 안의 다른 토큰을 직접 참고하고, 문맥이 반영된 새로운 벡터를 만드는 과정을 살펴봤습니다. 하지만 실제 트랜스포머는 셀프 어텐션 외에도 여러 구성 요소가 결합된 구조입니다. 이 장에서는 이러한 구성 요소와 각각의 역할을 하나씩 살펴보며 트랜스포머의 전체 구조를 이해해 보겠습니다.
트랜스포머의 구조
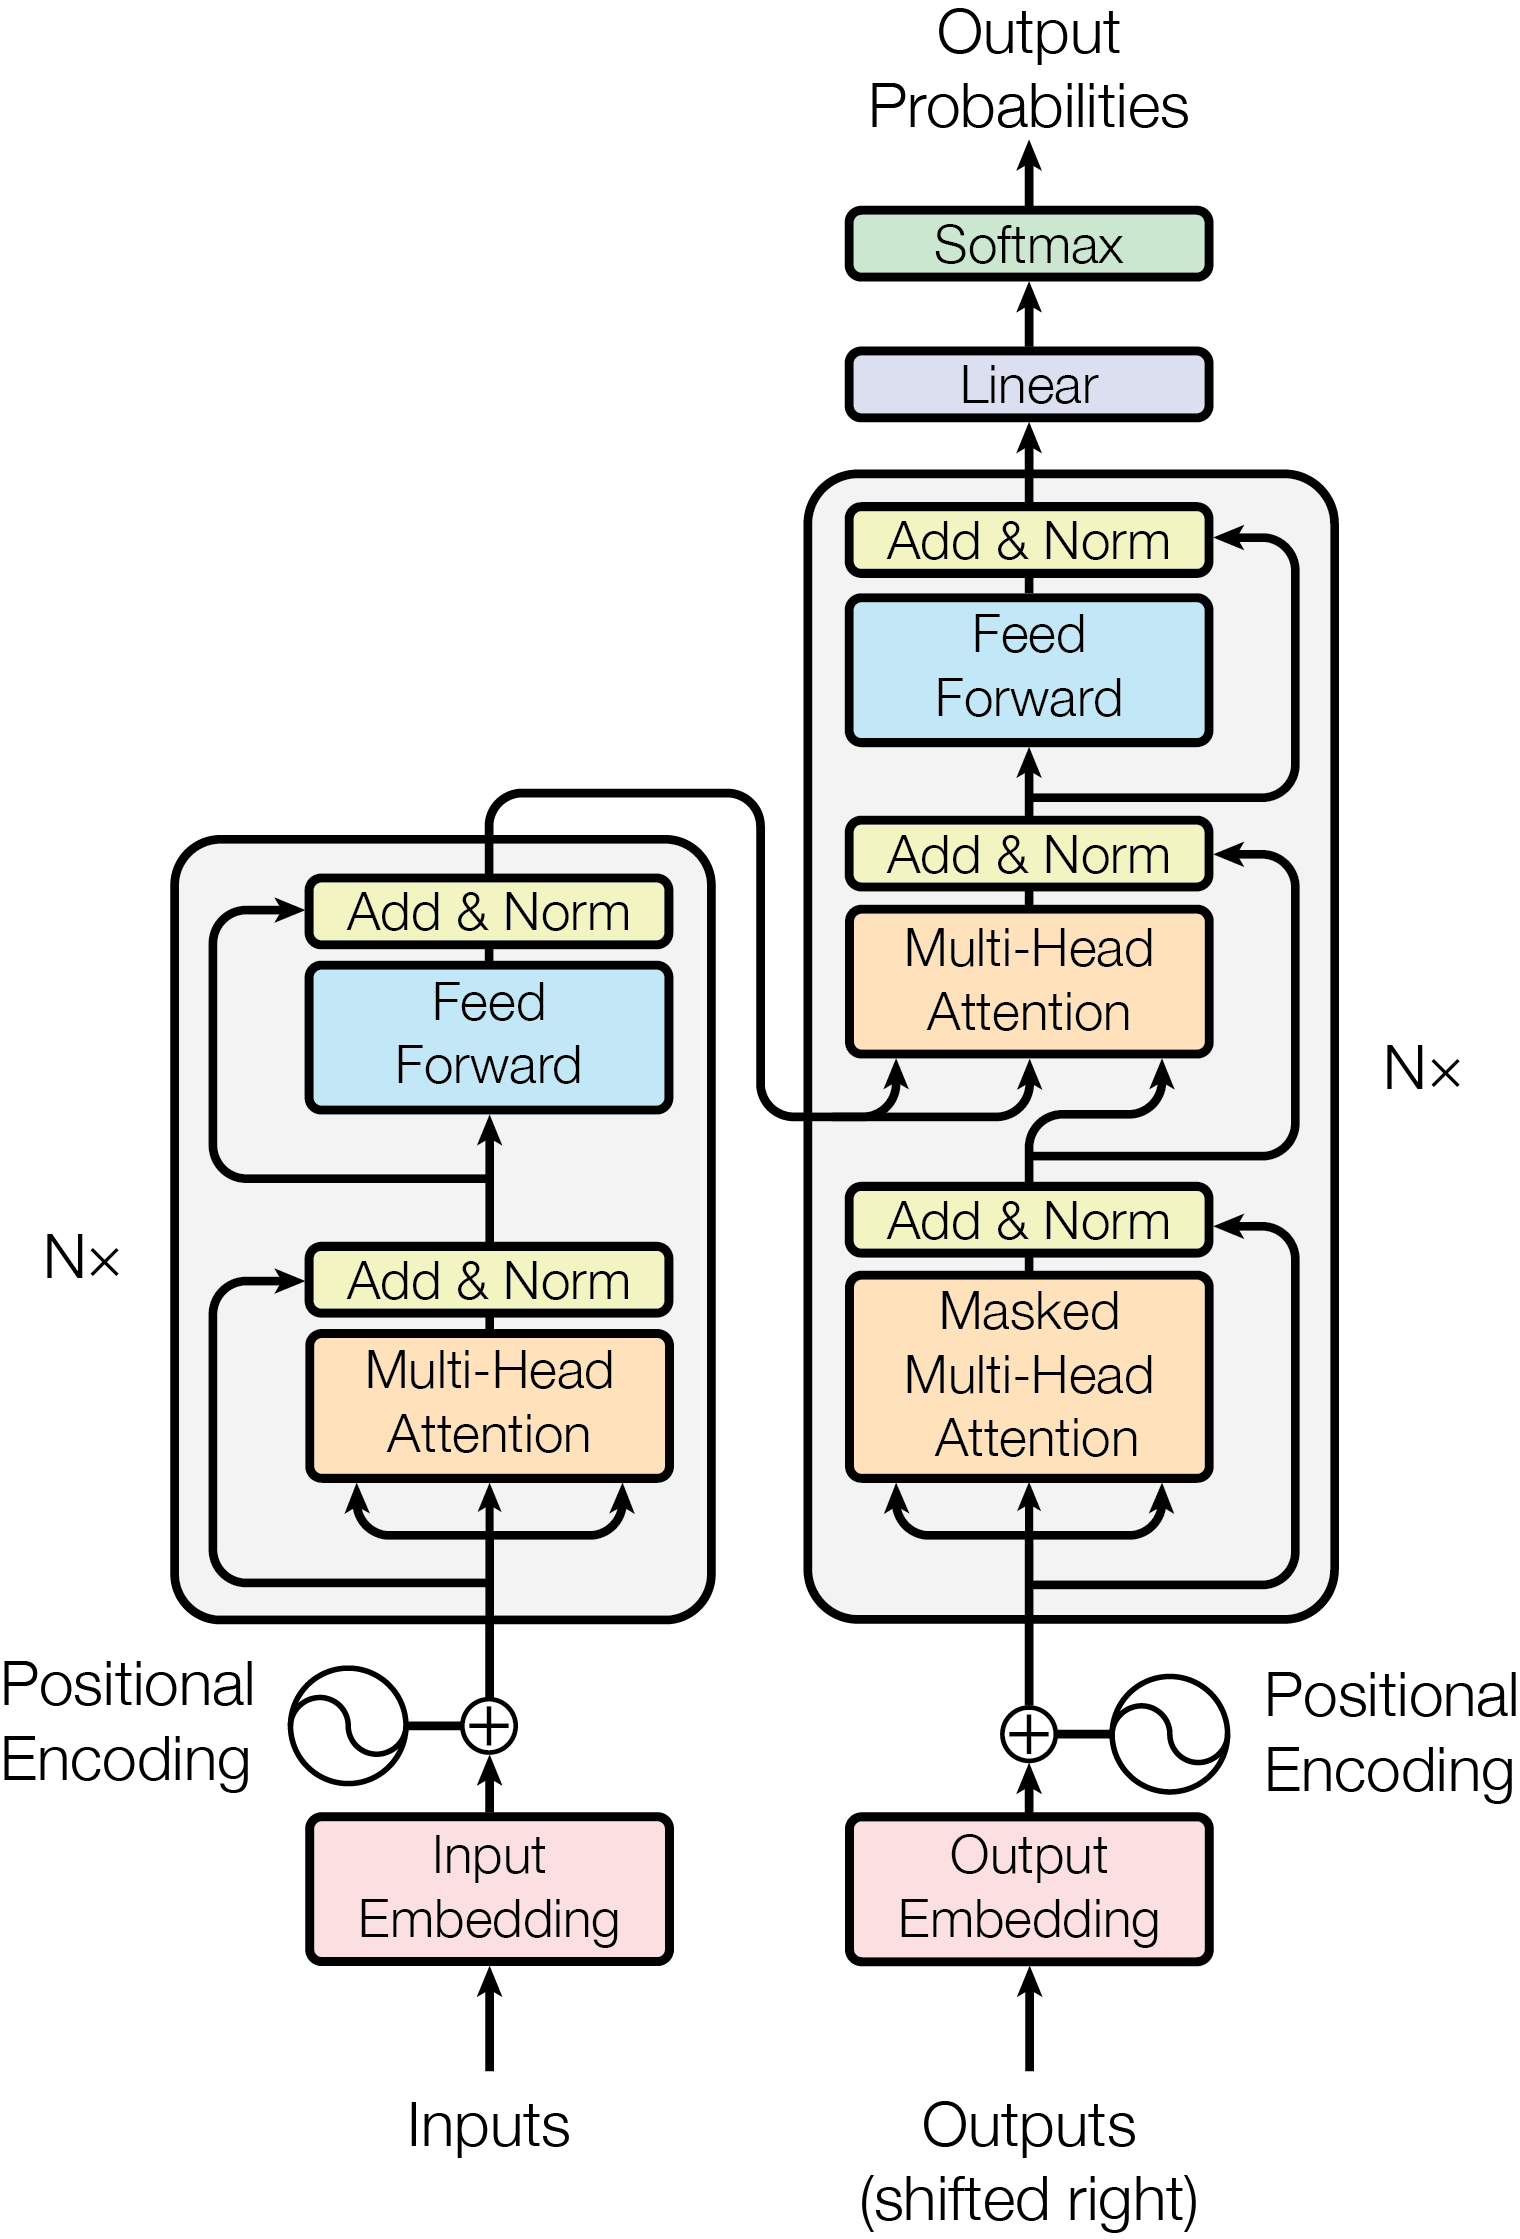
Vaswani et al., *Attention Is All You Need* (2017), Figure 1
이 그림은 Attention Is All You Need 논문에 제시된 트랜스포머의 전체 구조입니다.
트랜스포머는 크게 인코더(Encoder)와 디코더(Decoder)로 구성됩니다. 왼쪽의 인코더는 입력 토큰 사이의 관계를 파악해 문맥이 반영된 표현을 만들고, 오른쪽의 디코더는 이 표현과 앞서 생성한 토큰을 바탕으로 다음 토큰을 예측합니다.
그림에서 네모 박스로 묶인 부분을 각각 인코더 블록(Encoder Block)과 디코더 블록(Decoder Block)이라고 합니다. 트랜스포머는 이러한 블록을 여러 층 쌓은 구조이며, 그림의 N× 표시는 각 블록이 N번 반복된다는 뜻입니다.
원 논문에서는 이러한 구조를 영어-독일어와 영어-프랑스어 번역 과제에 적용해 성능을 검증했습니다.
먼저 인코더가 입력을 어떻게 처리하는지 살펴보겠습니다.
입력 임베딩
트랜스포머가 문장을 처리하려면 먼저 모델이 사용할 토큰의 목록인 어휘집(vocabulary)이 필요합니다. 어휘집에 토큰이 n개 있다고 해 봅시다. 각 토큰에는 구분을 위한 고유한 토큰 ID가 부여됩니다. 토큰 ID는 단지 토큰을 식별하는 번호일 뿐, 토큰의 의미나 다른 토큰과의 관계를 담고 있지는 않습니다.
이러한 토큰을 모델이 처리할 수 있는 숫자 벡터로 변환하기 위해 임베딩 테이블(embedding table)을 사용합니다. 임베딩 테이블에는 각 토큰 ID에 대응하는 벡터가 저장되어 있습니다. 원 논문의 영어-독일어 번역 모델에서는 약 37,000개의 토큰을 사용했으며, 각 토큰을 512차원의 벡터로 표현했습니다.
예를 들어 apple이라는 토큰도 512개의 숫자로 이루어진 벡터로 표현됩니다.
이렇게 각 토큰을 표현한 벡터를 임베딩 벡터(embedding vector)라고 합니다. 트랜스포머에서는 입력 토큰을 이러한 임베딩 벡터로 변환하는 과정을 입력 임베딩(input embedding)이라고 합니다.
입력 표현
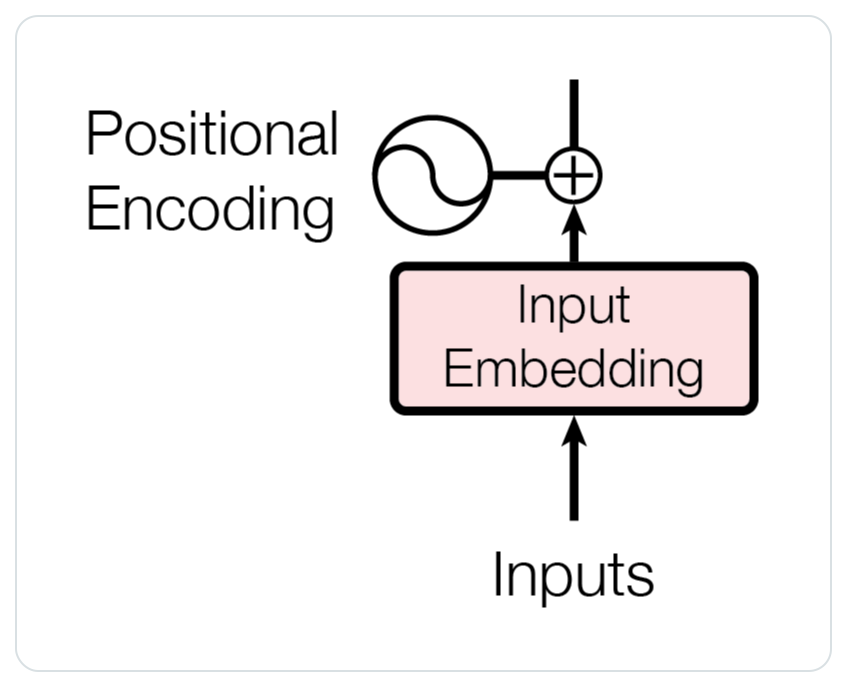
각 토큰을 임베딩 벡터로 표현하더라도, 이 벡터만으로는 해당 토큰이 문장의 어느 위치에 놓여 있는지 알 수 없습니다. 셀프 어텐션 자체에는 토큰의 순서를 구분하는 기능이 없기 때문에, 위치 정보를 별도로 알려 주어야 합니다.
이를 위해 각 토큰의 위치를 나타내는 위치 인코딩(positional encoding)을 입력 임베딩에 더합니다. 예를 들어 “Dog bites man”과 “Man bites dog”는 dog, bites, man이라는 같은 토큰을 사용하지만, 토큰의 순서가 달라 의미도 달라집니다. 위치 인코딩은 모델이 이러한 순서의 차이를 구분하도록 돕습니다.
이렇게 입력 임베딩과 위치 인코딩을 더한 벡터가 입력 표현(input representation)이 되어 인코더 블록으로 전달됩니다.
다중 헤드 어텐션
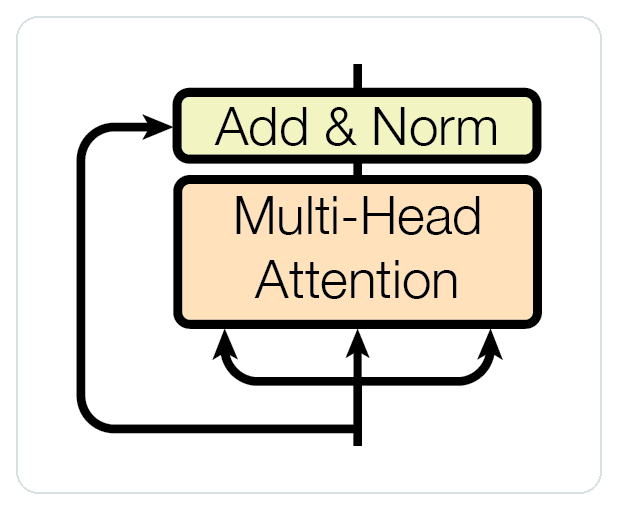
인코더 블록은 먼저 다중 헤드 어텐션(multi-head attention)으로 입력 표현을 처리합니다. 다중 헤드 어텐션은 서로 다른 가중치를 사용해 여러 개의 셀프 어텐션을 병렬로 수행하는 방식이며, 각각을 헤드(head)라고 부릅니다. 각 헤드는 서로 다른 Q, K, V 가중치를 사용하므로, 하나는 주어와 동사의 관계, 다른 하나는 대명사가 가리키는 대상, 또 다른 하나는 멀리 떨어진 단어 사이의 관계처럼 서로 다른 패턴에 주목하도록 학습될 수 있습니다.
이렇게 계산된 결과는 다음 단계인 Add & Norm으로 전달됩니다. 그런데 그림을 보면 입력이 다중 헤드 어텐션을 거치지 않고 왼쪽으로 우회해 Add & Norm으로 바로 연결되는 경로가 하나 더 있습니다. 이것이 잔차 연결(residual connection)입니다.
잔차 연결은 어떤 층에 들어온 입력을 해당 층의 출력에 그대로 더해 주는 방식입니다. 새롭게 계산된 값에 원래 입력을 더함으로써 기존 정보를 활용할 수 있게 하고, 층이 깊어져도 정보와 기울기가 원활하게 전달되어 모델을 안정적으로 학습할 수 있도록 돕습니다.
Add & Norm에서는 먼저 잔차 연결을 통해 전달된 원래 입력과 다중 헤드 어텐션의 출력을 더합니다(Add). 그다음 더한 결과에 레이어 정규화(layer normalization)를 적용합니다(Norm). 레이어 정규화는 각 토큰 벡터의 값들을 평균 0, 분산 1이 되도록 표준화한 뒤, 학습 가능한 파라미터를 사용해 다시 조정하는 연산입니다. 이를 통해 값의 분포가 지나치게 흔들리는 것을 줄이고 학습을 안정적으로 진행할 수 있습니다.
피드 포워드 신경망(FFN)
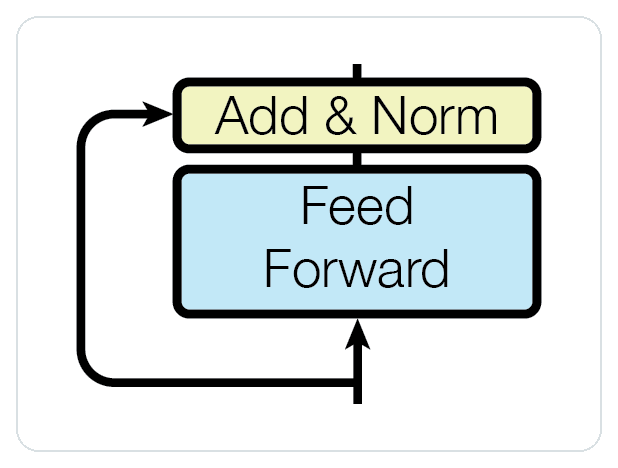
이렇게 정규화된 값은 다음 피드 포워드 신경망(Feed-Forward Network, FFN)으로 넘어갑니다. FFN은 작은 다층 신경망(MLP)입니다.
앞의 셀프 어텐션이 토큰 사이의 관계를 파악하고 정보를 주고받는 과정이라면, FFN은 이렇게 얻은 문맥 정보를 바탕으로 각 토큰의 벡터를 추가로 변환하는 역할을 합니다. 이 과정에서 학습된 가중치를 이용해 벡터에 담긴 의미적·문법적 특징을 더욱 정교하게 표현합니다. 셀프 어텐션과 달리 다른 토큰을 추가로 참고하지 않고, 각 토큰의 벡터를 개별적으로 처리합니다.
왜 피드 포워드라고 부를까?
FFN에서는 입력된 정보가 여러 층을 거쳐 출력으로 한 방향으로만 전달됩니다. RNN처럼 이전 단계로 되돌아가는 순환 연결이 없기 때문에 피드 포워드(Feed-Forward) 신경망이라고 부릅니다.
셀프 어텐션은 토큰 사이의 관계를 반영하지만, 그 결과를 복잡한 형태로 변환하는 데는 한계가 있습니다. FFN은 모든 토큰에 동일한 신경망을 적용해 비선형 변환(nonlinear transformation)을 수행함으로써, 어텐션을 통해 얻은 정보를 더욱 복잡한 형태로 표현할 수 있도록 합니다.
비선형 변환은 쉽게 말해 직선으로 표현할 수 없는 변화를 만들어 내는 것입니다. 원 논문의 트랜스포머 FFN에는 ReLU라는 활성화 함수가 사용됩니다. ReLU는 입력값이 0보다 작으면 0으로 바꾸고, 0 이상이면 그대로 통과시킵니다. 이 과정에서 그래프에 꺾이는 지점이 생기며, 신경망에 비선형성을 더합니다.
반대로 활성화 함수가 없다면 층을 아무리 많이 쌓아도 전체 계산은 하나의 선형 변환과 편향으로 표현할 수 있습니다. 선형성(linearity)이란 입력과 출력 사이에 일정한 비례 관계가 성립하는 성질로, 하나의 입력과 출력으로 나타내면 원점을 지나는 직선 형태가 됩니다.
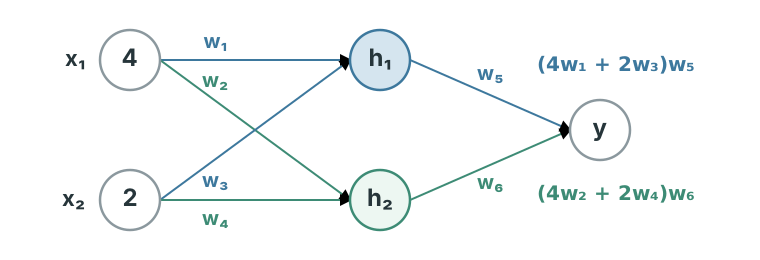
예를 들어 입력값이 4와 2이고, 은닉층에 두 개의 노드가 있다고 해 봅시다. 전체 계산 과정은 다음과 같습니다.
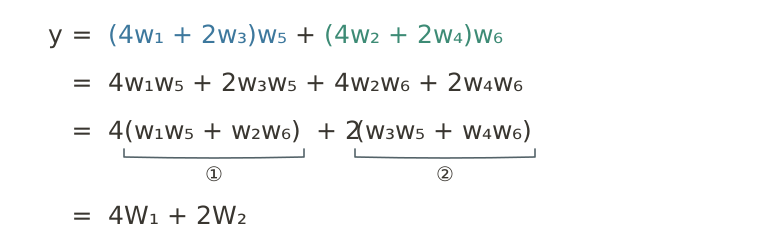
여기서 ① w₁w₅ + w₂w₆은 첫 번째 입력값 4에 곱해지는 하나의 값입니다. 각 w는 학습된 가중치이므로, 이들을 곱하고 더한 결과도 하나의 숫자가 됩니다. 따라서 이 값을 W₁으로 정의할 수 있습니다. 마찬가지로 두 번째 입력값 2에 곱해지는 ② w₃w₅ + w₄w₆도 W₂로 정의할 수 있습니다.
따라서 전체 식은 y = 4W₁ + 2W₂로 간단하게 표현할 수 있습니다. 즉, 활성화 함수가 없다면 여러 층을 통과하더라도 결국 하나의 층을 통과한 것과 동일한 결과를 얻습니다.
이러한 한계를 극복하기 위해 MLP에서는 층 사이에 ReLU와 같은 활성화 함수를 사용합니다. 활성화 함수가 비선형성을 추가하면 여러 층의 계산을 더 이상 하나의 선형 변환으로 합칠 수 없게 됩니다. 이를 통해 신경망은 더욱 복잡한 패턴을 학습할 수 있습니다.
예를 들어 위와 같은 데이터 분포를 MLP에 입력하면, 각 뉴런은 입력값에 가중치를 곱하고 더해 하나의 값을 계산합니다. 이 값이 특정 기준보다 큰지 작은지에 따라 입력을 구분할 수 있으며, 이러한 기준은 그래프에서 직선 형태의 경계로 나타납니다.
각 뉴런이 만드는 경계는 단순한 직선이지만, 활성화 함수를 적용하고 여러 뉴런의 결과를 조합하면 마지막 그래프처럼 하나의 직선으로는 표현할 수 없는 복잡한 경계도 만들 수 있습니다. 즉, 여러 층과 활성화 함수를 통해 신경망은 더욱 복잡한 패턴을 구분할 수 있게 됩니다.
트랜스포머의 FFN도 이러한 원리를 이용해 셀프 어텐션을 통해 얻은 정보를 비선형적으로 변환하고, 더 복잡한 특징을 학습합니다.
FFN의 출력은 다시 Add & Norm을 거칩니다. FFN에 입력되었던 벡터를 잔차 연결을 통해 출력에 더하고(Add), 그 결과에 레이어 정규화를 적용합니다(Norm).
이처럼 다중 헤드 셀프 어텐션부터 마지막 Add & Norm까지의 과정이 하나의 인코더 블록(Encoder Block)을 구성합니다. 원 논문의 트랜스포머는 이러한 인코더 블록을 6개 쌓아 인코더를 구성했습니다.
실습 과제
다음 문장이 맞으면 O, 틀리면 X를 선택하세요.
- 임베딩 벡터의 차원 수는 하나의 토큰을 표현하는 숫자의 개수이다.
- 위치 인코딩은 같은 토큰으로 구성된 문장이라도 어순이 다름을 구분하도록 돕는다.
- 다중 헤드 어텐션의 각 헤드는 모두 같은 Q, K, V 가중치를 사용한다.
- 잔차 연결은 블록에서 변환된 결과에 원래 입력을 다시 더해주는 방식입니다.
- 활성화 함수 없이 선형 층만 여러 개 쌓으면, 전체 계산은 하나의 선형 변환으로 정리된다.
정답·해설
- O — 예를 들어 512차원 임베딩 벡터는 숫자 512개로 하나의 토큰을 표현합니다.
- O — 위치 인코딩이 토큰의 순서 정보를 더해 줍니다.
- X — 각 헤드는 서로 다른 Q, K, V 가중치를 학습해 서로 다른 관계에 주목할 수 있습니다.
- O — 원래 입력을 변환된 결과에 다시 더해, 층이 깊어져도 기존 정보와 학습 신호가 잘 전달되도록 합니다.
- O — 그렇기 때문에 MLP에서는 층 사이에 활성화 함수를 추가해 비선형성을 만들고, 더 복잡한 패턴을 학습할 수 있게 합니다.